Harness Mühendisliği Anatomisi ve Ajan Döngüsü
Merhabalar.
Bugün; Büyük Dil Modellerinin (Large Language Model – LLM) kod üretme becerilerinden ziyade, bu becerinin gerçek bir yazılım projesinde nasıl güvenilir sonuçlara dönüştürüldüğünü ele almaya çalışacağız. Aynı modeli kullanan iki kodlama ajanından biri hatayı birkaç adımda bulurken diğeri neden yanlış dosyaları düzenliyor, testleri atlıyor veya bağlamını kaybediyor? Sorunun yanıtı çoğu zaman modelin kendisinde değil, onu çalışma ortamına bağlayan mühendislik katmanında saklı: Harness.
TÜBİTAK BİLGEM Yazılım Teknolojileri Araştırma Enstitüsünün (YTE) 2026 tarihli “Kodlama Ajanı Kullanıcıları için Harness Mühendisliği” araştırması, bu yapıyı modelin etrafındaki araç, bağlam, yürütme, doğrulama ve güvenlik sistemleriyle açıklıyor. Çalışmanın odağı yeni bir model önermek değil; mevcut modellerden daha denetlenebilir, öngörülebilir ve ölçülebilir çıktı alabilmek.
Buradaki kritik ayrım şu;
Güçlü bir modele sahip olmak, tek başına güçlü bir yazılım geliştirme süreci oluşturmaz. Ajanın nerede çalıştığı, neyi okuyabildiği, hangi komutu hangi izinle çağırabildiği ve ürettiği kodun nasıl sınandığı da sonucun parçasıdır.
Kodlama ajanının başarısı yalnızca model kalitesi değil; model ile harness’ın birlikte ortaya çıkardığı mühendislik performansıdır.
Aynı Model Neden Farklı Sonuç Verir?
Harness Mühendisliği Anatomisi ve Ajan Döngüsü
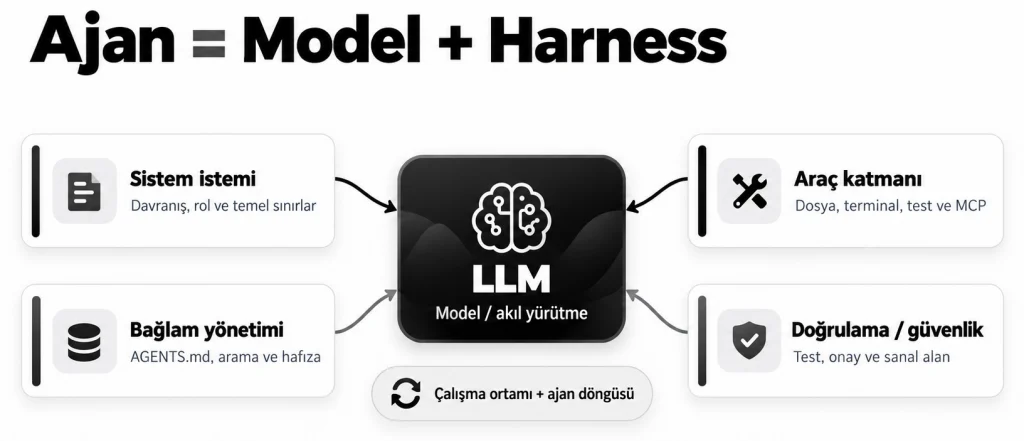
Bir LLM, kendisine sunulan bağlam üzerinden sıradaki çıktıyı üretir. Bunun tek başına proje klasörünü okuyabildiği, terminal açabildiği, Git geçmişini görebildiği veya oluşturduğu kodu test edebildiği anlamına gelmediğini ayırmamız gerekir. Ajan ise modeli bir çalışma döngüsüne yerleştirir; araç çağrılarını çalıştırır, sonuçları tekrar bağlama ekler ve görev tamamlanana kadar süreci yönetir.
Rapordaki yalın formülle anlatırsak;
Ajan = Model + Harness (PDF, s. 9).
Örneğin aynı modele “Bu hata neden oluşuyor?” sorusunu yönelttiğimizi düşünelim. Bir ajan ilgili hata kayıtlarını, çağrı zincirini ve test sonucunu görebilirken diğeri yalnızca kullanıcının hata açıklamasını okuyorsa, iki çıktının aynı kalitede olmasını beklemek doğru olmaz. Buradaki fark yalnızca akıl yürütme kapasitesi değil, modele sunulan gözlemin niteliğidir
Prompt Engineering’den Harness Engineering’e
İstem Mühendisliği (Prompt Engineering) tek etkileşimin talimatlarını iyileştirir.
Bağlam Mühendisliği (Context Engineering) hangi bilginin modele gireceğine odaklanır.
Harness Mühendisliği (Harness Engineering) ise bunları kapsayarak araçları, yürütme ortamını, izinleri, testleri ve gözlemlenebilirliği birlikte tasarlar. Başka bir ifadeyle, iyi bir prompt görev tanımını iyileştirirken iyi bir harness görevin yürütülme koşullarını iyileştirir (PDF, s. 10).
Harness Mühendisliği Anatomisi ve Ajan Döngüsü
Raporda temel yapı; ajan döngüsü, sistem istemi, araç katmanı ve çalışma ortamı üzerinden anlatılıyor. Bağlam yönetimi, doğrulama ve güvenlik sınırları bu çekirdeği tamamlıyor.
Her bileşen başka bir mühendislik sorusunu karşılıyor:
Model ne yapacak, hangi bilgiye ulaşacak, eylemini nasıl yürütecek ve doğru yaptığını nasıl anlayacak?
| Bileşen | Görevi | Eksik kalırsa |
| Sistem istemi | Davranış, öncelik ve çıktı sınırları | Tutarsız görev yürütme |
| Araçlar | Dosya, terminal, test ve harici sistem etkileşimi | Eylem yerine varsayım |
| Çalışma ortamı | Dosya sistemi, Git, paketler, sandbox | Tekrarlanamaz veya riskli yürütme |
| Bağlam yönetimi | Doğru bilginin doğru turda sunulması | Bağlam taşması ve yanlış varsayım |
| Doğrulama | Test, lint, derleme ve geri bildirim | Hatanın fark edilmemesi |
| İzin / Güvenlik | Yetki, ağ ve insan denetimi | İstenmeyen veya zararlı eylem |
Doğrulama Geri Bildirimi Neden Belirleyicidir?
Bir kodlama ajanının temel döngüsü; bağlamı inceleme, sonraki eylemi seçme, aracı çalıştırma, elde edilen gözlemi geri besleme ve gerekirse yeniden deneme şeklinde ilerler. Bu nedenle “kod yazıldı” ifadesi tamamlanmış iş anlamına gelmez.
Derleme sonucu, birim testleri, tip denetimi, lint ve gerekiyorsa mimari kural testleri başarının kanıtıdır. Testi çalıştıramayan ajan ürettiği kodun doğruluğunu ancak tahmin edebilir (PDF, s. 11, 20).
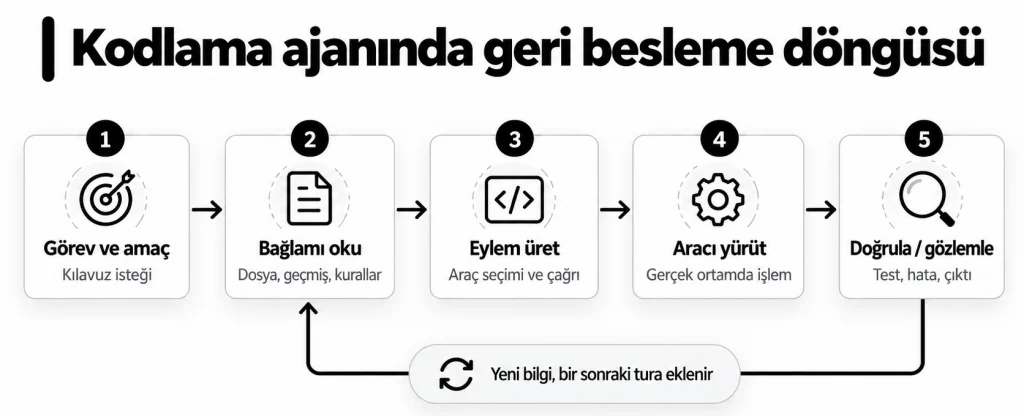
Pratikte ilk kurulacak otomasyon, çok karmaşık bir ajan orkestrasyonu değil; tek komutla çalışan doğrulama zinciridir. Örneğin derleme, test ve lint adımlarının AGENTS.md içinde net biçimde tanımlanması, ajanın başarısızlık çıktısını görüp yeniden denemesini sağlar. Güçlü geri bildirim, gereksiz özgüvenden daha değerlidir.
Bağlam Mühendisliği: Agents.md, Arama ve Hafıza
Ajanın bağlam penceresi sınırsız bir depo değildir. Sistem talimatları, araç açıklamaları, okunmuş dosyalar, terminal çıktıları ve konuşma geçmişi aynı kapasiteyi paylaşır. Gereksiz binlerce satırın modele yüklenmesi hem maliyeti artırır hem de ilgili bilginin geri çağrılmasını zorlaştırabilir. Raporda vurgulanan “context rot”, uzun oturumlarda bağlam büyüdükçe yaşanabilen bu dikkat ve erişim kaybını tarif eder (PDF, s. 15).
Tam Zamanında Arama, Sıkıştırma ve Kalıcı Notlar
İlk yöntem, “her şeyi baştan okutmak” yerine tam zamanında bağlam toplamaktır. Ajan önce dizinleri ve sembolleri arar, ardından yalnızca ilgili dosya bölümlerini okur. İkinci yöntem sıkıştırmadır (compaction): uzun oturumdaki kritik kararlar korunur, gereksiz ayrıntılar özetlenir. Üçüncü yöntem ise structured note-taking olarak anılan yapılandırılmış notlardır; alınan kararlar ve kalan işler bağlam penceresi dışında saklanır. Sıkıştırmanın kayıplı olabileceği unutulmamalı; ara kararların kalıcı olarak kaydedilmesi gerekir.
Kalıcı proje bağlamının merkezinde agents.md yer alır. Bu dosya bir ansiklopedi değildir. Derleme/test komutları, kritik mimari sınırlar ve ajanın tekrar yaptığı hatalar kısa, emir kipinde yazılır; ayrıntılı belgeler yalnızca gerektiğinde referans üzerinden okunur. PDF’nin 28. sayfasındaki kurumsal proje kesiti tam olarak bu “önce az, sonra gerektiği kadar” mantığını gösteriyor.
Agents.md / Editoryal Uyarlama — PDF’den Doğrudan Alıntı Değildir
# agents.md — TEMSİLİ ÖRNEK
## Çalışma kuralları
- Değişiklikten önce ilgili modülü ve testleri incele.
- İlişkisiz dosyaları değiştirme.
- Test için: ./gradlew test
- Mimari değişiklikte: docs/architecture.md dosyasını oku.
- İş bittiğinde test çıktısını ve riskleri özetle.
Bu örnek dosya editoryal olarak hazırlanmıştır; belirli bir projede geçerli olduğu iddia edilmez. Gerçek projede komutlar ve doküman yolları o depoda çalıştığı doğrulandıktan sonra eklenmelidir.
Araç Katmanı: MCP, LSP ve ACP Neyi Çözer?
Modelin araç çağrısı üretebilmesi başka, bu çağrının güvenilir biçimde yerine getirilmesi başkadır. Harness kendi dosya ve terminal araçlarını sunabilir; harici araçları MCP üzerinden bağlayabilir; sembol analizini LSP ile, editör ilişkisini ACP ile düzenleyebilir. Bunlar aynı protokolün farklı adları değildir (PDF, s. 16–20).
| Protokol | Temel sorusu | Örnek işlev |
| MCP | Ajan dış araçlara ve kaynaklara nasıl bağlanır? | GitHub / kurumsal doküman / veri kaynağı |
| LSP | Kodun sembolik yapısı nasıl okunur? | Tanıma gitme, referans, tip hatası |
| ACP | Editör ile ajan arka ucu nasıl konuşur? | Farklı ajanların ortak editör arayüzü |
| A2A | Farklı ajanlar birbirleriyle nasıl görev paylaşır? | Ajanlar arası görev devri; PDF’de kısa ele alınır |
MCP sunucusu eklemek ajana yalnızca kabiliyet değil, yeni bir yetki yüzeyi de ekler. Bu nedenle “mümkün olan her entegrasyonu açalım” yaklaşımı doğru bir varsayılan değildir. Araç açıklamaları açık olmalı, sonuçlar gereksiz ham verilerle bağlamı doldurmamalı ve kritik eylemler uygun onaydan geçmelidir. Raporda özellikle az sayıda, işi tamamlayan ve ne zaman kullanılacağı belli araçların tercih edilmesi önerilir.
ETCLOVG: Harness’ı Yedi Katmanda Okumak
Bileşenler tek tek doğru kurulduğunda bile aralarındaki ilişki zayıfsa ajan kırılgan kalabilir. Raporda başvurulan
ETCLOVG taksonomisi, sistemi yedi katmanda değerlendirir:
–Execution (yürütme ortamı),
–Tooling (araç arayüzü),
–Context (bağlam),
–Lifecycle (yaşam döngüsü),
–Observability (gözlemlenebilirlik),
–Verification (doğrulama)
–Governance (yönetişim).
Bu yapı, bir ürün seçme cetvelinden çok eksik katmanları tespit eden kontrol listesi olarak anlamlıdır (PDF, s. 14; kaynak [18]).
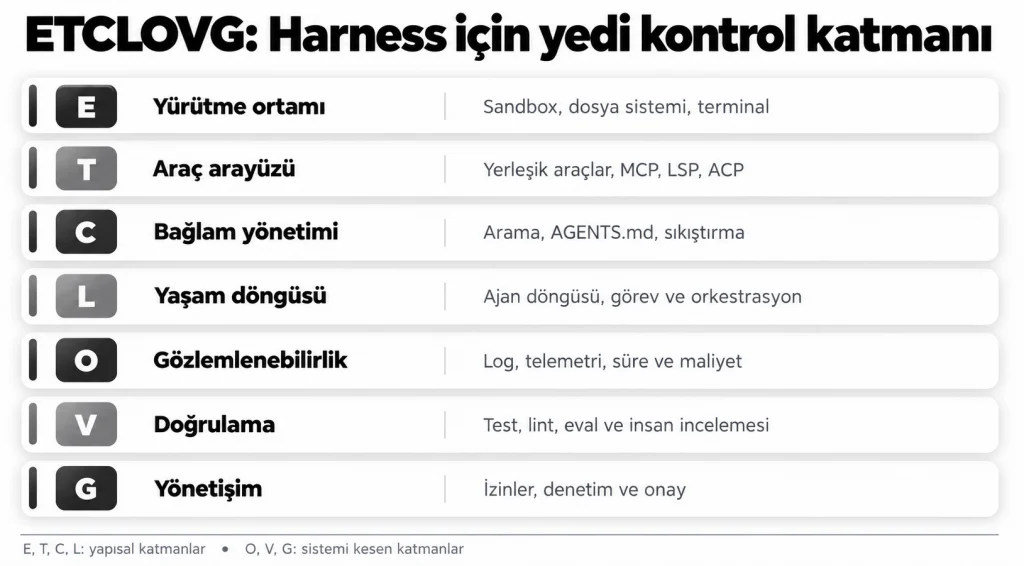
Özellikle Observability ve Governance katmanları, kullanıcı gözünden kolayca geri plana düşüyor. Ajan doğru dosyayı değiştirmiş olabilir; fakat bunun kaç tur, kaç araç çağrısı ve ne kadar maliyetle gerçekleştiği kaydedilmiyorsa iyileştirmeyi ölçmek zorlaşır. Aynı şekilde izin kararları belirli bir kullanıcıda doğru çalışsa da ekip çapında standart değilse risk başka oturumlarda yeniden ortaya çıkar.
Güvenlik ve İzin Modeli: Özerklik Her Zaman Avantaj Değildir
Dosyaları değiştirebilen, terminal komutu çalıştırabilen ve ağa çıkabilen bir ajan, yalnızca bir metin üretim sistemi olarak değerlendirilemez. Güvenlik üç düzeyde kurulmalıdır: ne yapabileceği (izin), nerede yapacağı (sandbox), hangi içeriği talimat kabul edeceği (güven sınırı). Bu ayrım; yerel ajanlarda dosya silme, bulut ajanlarında ise kaynak kodunun taşındığı ortam, kimlik bilgileri ve ağ erişimi gibi risklere kadar uzanır (PDF, s. 21–22).
Simon Willison’ın Ölümcül Üçlü çerçevesi, özel verilere erişim, güvenilmeyen içerik ve dışarıya veri gönderme kanalının aynı ajanda birleşmesinin veri sızıntısı riski doğurduğunu gösterir. Bu üç unsurdan en az birini güçlü denetimle ayırmak, özellikle dış MCP sunucuları ve internetten okunan içerikler söz konusu olduğunda temel savunmalardandır (PDF, s. 22–23; kaynak [14]).
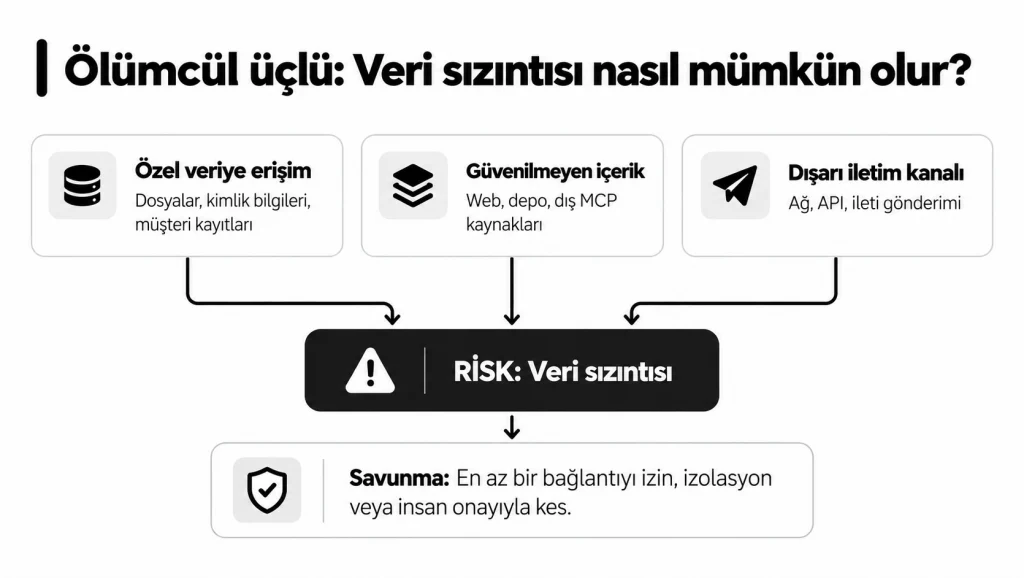
İzinler de göreve göre ayrılmalı: dosya okuma ile üretim veritabanını değiştirme aynı özerklik düzeyinde olmamalı. Silme, geçmişi yeniden yazma ve dış sisteme yayınlama gibi geri dönüşü zor işlemlerde açık onay kapıları gerekir.
PDF’nin Şekil 7’si bu yaklaşımı komut örüntüleriyle yapılandırmayı gösterir.
Pdf şekil-7 (S. 30) üzerinden çözümlenmiş opencode.json izin kesiti;
{
  "permission": {
    "bash": {
      "git checkout *": "ask",
      "git commit *": "ask",
      "git push *": "ask",
      "git reset *": "ask",
      "git rebase *": "ask",
      "rm -rf *": "ask"
    }
  }
}
Burada ask doğrudan yürütme yerine insan onayı ister.
Kod, PDF içindeki görsel kesitten aktarılmıştır; uygulanacağı yazılım sürümünde sözdizimi ve izin kapsamı ayrıca kontrol edilmelidir.
Çoklu Ajan Mimarisi: Daha Fazla Ajan, Her Zaman Daha Hızlı Değil
Bir görev birbirinden bağımsız araştırma başlıklarına ayrılabiliyorsa yönetici–işçi (orchestrator–worker) deseni değer üretir. Yönetici ajan iş paketlerini ayırır, alt ajanlar temiz bağlamlarda çalışır ve yalnızca özetlerini döndürür. Böylece ana ajanın bağlamı yüzlerce sayfalık ara çıktı ile dolmaz. Ne var ki aynı dosyada çakışan değişikliklerin birden fazla ajan tarafından yapılması birleştirme maliyetini büyütebilir (PDF, s. 23–26).
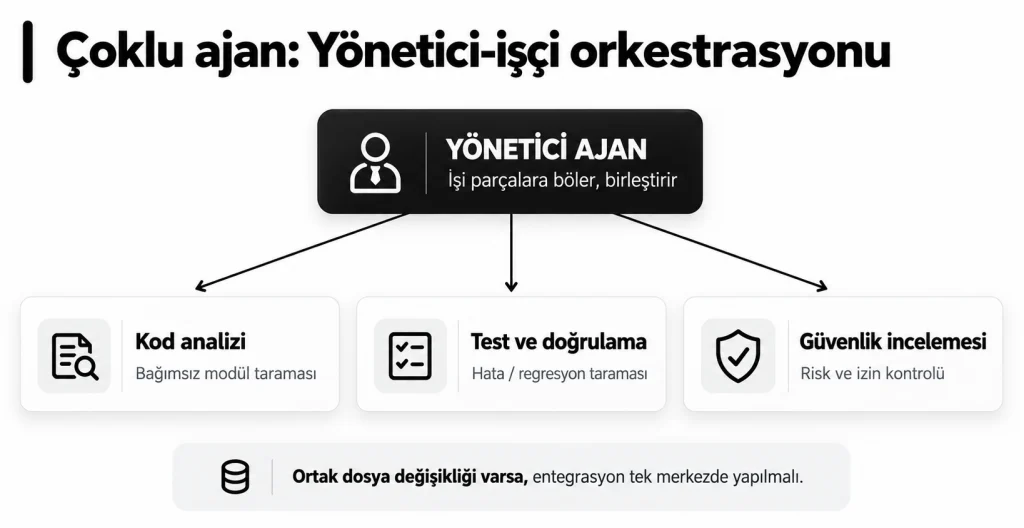
Raporun aktardığı Anthropic araştırmasında çoklu ajanlı sistem, ilgili şirket içi değerlendirmede tek ajanlı kurulumdan %90,2 daha iyi sonuç vermiştir. Aynı kaynağa dayanan yaklaşık 4× ve 15× token karşılaştırmaları ise çoklu ajanların bedelsiz ölçeklenmediğini hatırlatıyor. Bu verileri tipik bir kod tamamlama görevinin beklenen kazancı gibi okumak yanıltıcıdır; çalışma daha çok geniş ve paralel keşif görevlerinin sınırları içinde değerlendirilmelidir (PDF, s. 8, 24, 26; [12]).
Evals ve Telemetri: Ajanı Gerçekten Ölçmek
Harness ayarı da bir mühendislik hipotezidir;
Yeni bir agents.md kuralı eklersem hata sayısı azalacak,
Şu MCP aracını kapatırsam gereksiz token harcaması düşecek,
Plan moduyla yeniden çalışma azalacak
gibi.
Bir hipotezi doğru kabul etmek için aynı gerçekçi görevler üzerinde tekrar ölçmek gerekir. PDF, başlangıç için geçmişten seçilmiş 10–20 gerçek görevden oluşan küçük bir değerlendirme setini yeterli bir ilk adım olarak görüyor (s. 26).
Bu gerekliliği METR’nin 2025 deneyinden aktarılan çarpıcı fark da destekliyor: 16 deneyimli açık kaynak geliştiricisinin 246 görevine dayanan belirli koşullardaki deneyde, dönemin yapay zeka araçlarını kullananlar ölçümde %19 daha yavaş kalırken kendilerini %20 hızlanmış hissediyordu. Bu oranlar tüm LLM araçları için kalıcı sonuç değildir; ancak öznel hız algısının güvenilir değerlendirme yerine geçemeyeceğini gösterir (PDF, s. 8, 34; [10]).

| İzlenecek metrik | Cevapladığı soru |
| Görev başarı oranı | Ajan gerçek işi tamamlıyor mu? |
| Tur / araç çağrısı | Aynı iş için gereksiz çevrim oluşuyor mu? |
| Token / maliyet | Kalite artışı kaynak tüketimiyle uyumlu mu? |
| Süre / insan müdahalesi | Kazanım kullanıcı zamanına yansıyor mu? |
| Test / güvenlik ihlali | Üretilen çözüm güvenilir ve sınırlar içinde mi? |
Özellikle “görev tamamlandı” bilgisini tek başına başarı metriği gibi kullanmamak gerekir. Kabul edilebilir çıktı; çalışan, test edilmiş, mimari sınırlara uyan ve geri alınabilir değişikliktir. Ölçüm kaydı olmadan yapılan bir harness iyileştirmesini gerçek bir iyileştirme olarak adlandırmak da zordur.
OpenCode Örneği ve Uygulanabilir Kurulum Planı
PDF, katmanları somutlaştırmak için açık kaynaklı OpenCode’u örnek inceliyor. Belgedeki 2026 çerçevesinde OpenCode; sağlayıcıdan bağımsız tasarım, istemci–sunucu mimarisi, LSP geri bildirimi, agents.md, özelleştirilmiş komutlar, beceri paketleri ve proje düzeyinde opencode.json yapılandırmasıyla ele alınıyor (s. 31–33). Raporda açıklanan özellikler o dönemin ürün incelemesidir; güncel bir kurulumda resmi belge ve sürüm denetimi ayrıca gerekir.
Kurumsal bir projede uygulamayı aşağıdaki sırayla ele almak uygun olur:
- Mevcut durumu ölçün: 10–20 gerçek görev seçerek başarı, süre, maliyet ve test metrikleri için başlangıç değeri oluşturun.
- Projeyi tanıtın: kısa bir agents.md içinde çalıştırma komutlarını, mimari sınırları ve kritik klasörleri belirleyin.
- Araçları sadeleştirin: kullanılmayan entegrasyonları kapatın; gereken MCP sunucularını ve izinlerini ayrı ayrı onaylayın.
- Geri bildirim kurun: test, lint, derleme ve mümkünse mimari kuralları tek komutlarla çağrılabilir hale getirin.
- Riski sınırlayın: yıkıcı komutlar, dışa veri iletimi ve üretim değişiklikleri için insan onayı ve sandbox kullanın.
- Yineleyerek iyileştirin: aynı eval setiyle sürümleri kıyaslayın, logları okuyun ve harness yapılandırmasını kod incelemesiyle yönetin.
Böyle bir sırada model seçimi önemini kaybetmez; fakat model değiştirmeden önce çalışma ortamının gözlemlenebilir ve doğrulanabilir hale gelmesi sağlanır. Bu, eksik araç, yetersiz bağlam, yanlış izin ve doğrulama yoksunluğu gibi sorunları birbirinden ayırmayı kolaylaştırır.
***
Harness Mühendisliği, kodlama ajanlarını sihirli birer otomasyona dönüştürmekten çok, onları mühendislik ilkeleriyle yönetilebilir hale getirme disiplinidir. Aynı modelin farklı kurulumlarda farklı sonuç üretmesi şaşırtıcı değildir; çünkü görev yalnızca metin üretmekten ibaret değildir. Kodun doğru dosyada değiştirilmesi, test edilmesi, kayıt altına alınması ve kontrollü biçimde sunulması gerekir.
Bu nedenle “daha iyi bir ajan istiyorum” sorusundan önce şu soruları sormak daha yararlı;
Ajan doğru bağlamı bulabiliyor mu?
İhtiyacı olmayan yetkilere sahip mi?
Yazdığı kodu gerçekten çalıştırıp sınayabiliyor mu?
Başarısını ve maliyetini aynı görevlerle ölçüyor muyuz?
TÜBİTAK BİLGEM YTE araştırmasının sunduğu çerçeve, bu soruları tek bir harness mimarisinde birleştiriyor.
Sonuç olarak; güçlü model potansiyeli oluşturur, güçlü harness ise o potansiyelin tekrar edilebilir bir yazılım geliştirme pratiğine dönüşmesini sağlar.
Gelecek çalışmalarda görüşmek üzere.
İyi çalışmalar…