NLP (Natural Language Processing) – Doğal Dil İşleme Üzerine Mimari Yaklaşımlar [3]
Merhaba, iyi günler.
Bugün; insan dilini sayısal ortamda temsil etmeye çalışan klasik istatistiksel yaklaşımlardan, sözcükler arasındaki ilişkileri öğrenebilen ve bir cümlenin farklı bölümlerini birlikte değerlendirebilen sinirsel dil modellerine uzanan mimari gelişim üzerine notlarımın devamını [3] paylaşacağım.
Önceki bölümde; Naive Bayes ile metin sınıflandırmayı, Gizli Markov Modeli (HMM) ile gözlemlerin arkasındaki durum dizilerini ve N-Gram modelleriyle sözcüklerin sınırlı bir geçmiş üzerinden tahmin edilmesini incelemiştik. Bu üç yaklaşım, doğal dilin istatistiksel özelliklerini modellemek açısından güçlü bir temel sunuyordu. Ancak iki temel problem devam ediyordu;
1-Birbirine anlamca yakın sözcükler sistem açısından farklı kimlikler olarak ele alınıyor.
2-Uzun cümlelerde ise geçmiş bağlamın korunması giderek zorlaşıyordu.
Bu bölümde Word Embeddings, Word2Vec ve GloVe ile öğrenilebilir sözcük vektörlerini, Feed-Forward sinirsel dil modellerini, RNN, LSTM ve GRU mimarilerini, Encoder-Decoder yapıları ve son olarak Attention yaklaşımını ele alacağız.
Şimdiden iyi okumalar.
İstatistiksel NLP’den Sinirsel Temsillere Geçiş
N-Gram modelinde bir sözcüğün olasılığı, kendisinden önce gelen sınırlı sayıdaki sözcüğe göre hesaplanmaktadır.
Örneğin; “ekran kartı” ifadesi eğitim derleminde sık görülüyorsa, “ekran” sözcüğünden sonra “kartı” gelmesi yüksek bir olasılık kazanabilir. Ancak “grafik kartı” ifadesi eğitimde çok az görülmüşse, iki kullanımın benzer bir ürünü işaret ettiği bilgisi yalnızca sözcük sayımlarından doğrudan çıkarılamaz.
Sinirsel yaklaşımların getirdiği önemli değişiklik; sözcükleri yalnızca sözlükteki konumları üzerinden tanımlamak yerine, eğitim sürecinde güncellenebilen sayısal temsillerle ifade etmektir. Böylece model, farklı sözcüklerin benzer bağlamlarda kullanılması durumunda bu ilişkiden yararlanabilir. Üstelik bu vektörler, bir dil modelinin sonraki sözcüğü tahmin etme göreviyle birlikte öğrenilebilir.
Buradaki ayrım önemlidir.
İstatistiksel modeller de veriden öğrenir; sinirsel modellerin farkı, yalnızca sayım yapmak yerine parametreleri ve temsilleri bir kayıp fonksiyonuna göre birlikte optimize edebilmesidir.
Dağıtımsal Sözcük Temsilleri ve Word Embeddings
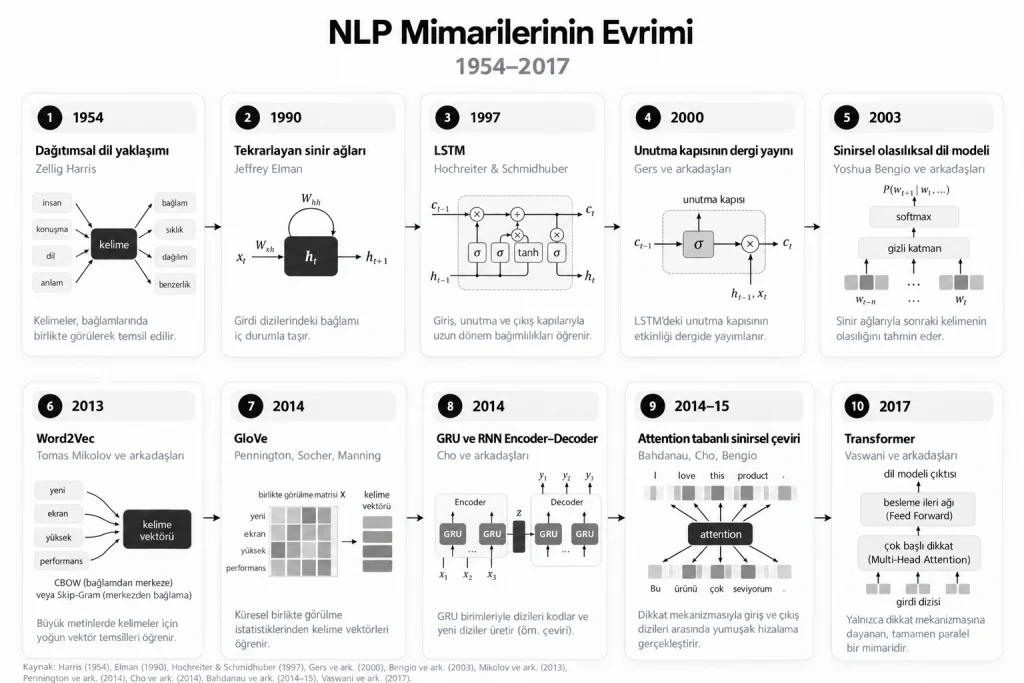
Dağıtımsal Yaklaşım (Distributional Approach); bir sözcüğün anlamına ilişkin önemli ipuçlarının, birlikte kullanıldığı diğer sözcüklerden elde edilebileceği düşüncesine dayanmaktadır. Zellig Harris’in 1954 tarihli çalışması bu yaklaşımın dilbilimsel zeminini oluşturan kaynaklardandır. Teknik açıdan bakıldığında, farklı sözcüklerin benzer bağlam örüntülerine sahip olması, bunların vektör uzayında benzer temsiller öğrenebilmesine imkan verir.
One-Hot Gösterimden Yoğun Vektörlere
Geleneksel One-Hot Encoding yaklaşımında; sözlükteki her sözcüğe, yalnızca tek bir konumu 1 olan bir vektör atanır. Sözlük büyüklüğü 10.000 ise, her sözcük 10.000 boyutlu ve büyük ölçüde sıfırlardan oluşan bir vektörle gösterilir. Bu yöntem sözcük kimliğini belirtir; fakat iki sözcük arasındaki yakınlığı tek başına açıklamaz.
Word Embedding (Sözcük Gömme) yaklaşımında ise, her sözcük çok daha düşük boyutlu, yoğun ve öğrenilebilir bir vektörle temsil edilmektedir.
Örneğin; 10.000 sözcüklük bir sözlük, her sözcük için 100 boyutlu bir embedding matrisiyle modellenebilir.
Buradaki 10.000 ve 100 değerleri yalnızca temsili mimari boyutlarıdır. Vektörün her bileşeni “fiyat”, “renk” veya “ürün” gibi önceden belirlenmiş tek bir anlama sahip olmak zorunda değildir. Anlamsal ve dilbilgisel özellikler genellikle birden fazla boyuta dağılmış biçimde öğrenilir.

Anlamsal Yakınlık Nasıl Ölçülür?
Öğrenilmiş iki vektörün; yön bakımından ne kadar yakın olduğunu incelemek için en yaygın ölçülerden biri Kosinüs Benzerliği (Cosine Similarity) yöntemidir.
Bu ölçü; sıfır olmayan vektörler için -1 ile 1 arasında değer alır. Değerin 1’e yaklaşması vektörlerin aynı yöne baktığını gösterir; ancak tek başına tam bir anlamsal eşdeğerlik kanıtı değildir.
Örneğin; elektronik ürün yorumlarından öğrenilen uygun bir modelde “ekran” ile “monitör”, “kulaklık” ile “mikrofon” veya “hızlı” ile “performanslı” arasında farklı düzeylerde yakınlıklar gözlenebilir. Bu eşleşmelerin ortaya çıkıp çıkmadığı; veri kümesine, ön işlemeye, modelin boyutuna ve eğitim parametrelerine bağlıdır. Ayrıca aynı bağlamda geçen karşıt anlamlı sözcükler de vektör uzayında yakın konumlanabilir.
Dolayısıyla vektör yakınlığı her zaman eş anlamlılık anlamına gelmemektedir.

Word2Vec: CBOW ve Skip-Gram Mimarileri
Tomas Mikolov ve çalışma arkadaşlarının 2013’te yayımladığı Word2Vec çalışmaları, büyük metin derlemlerinden sözcük vektörlerinin verimli biçimde öğrenilmesini sağlayan yöntemler arasında önemli bir yer edinmiştir.
Word2Vec tek bir model mimarisi değil; özellikle iki farklı tahmin görevi üzerinden kullanılan bir yöntem ailesidir.
CBOW (Continuous Bag of Words); çevredeki sözcüklerden merkezdeki sözcüğü tahmin etmeye çalışmaktadır.
Skip-Gram ise ters yönde ilerler.
Merkezdeki sözcükten yakın bağlam sözcüklerini tahmin eder.
“Yeni ekran kartı yüksek performans sağlıyor” cümlesinde merkez sözcüğü “kartı”, pencere boyutunu da iki sözcük olarak belirlediğimizi düşünelim.
- CBOW Girdisi
“yeni”, “ekran”, “yüksek”, “performans” → hedef: “kartı”. - Skip-Gram Örnekleri
“kartı” → “yeni”; “kartı” → “ekran”; “kartı” → “yüksek”; “kartı” → “performans”.
Bu örneklerde noktalama ve cümle sınırları sadeleştirilmiş, sözcükler yalnızca öğretim amacıyla ayrılmıştır. Word2Vec’in öğrenmeye çalıştığı temel ilişki; hangi sözcüklerin hangi bağlamlarda birlikte görülebileceğidir.

Skip-Gram’in öğrenme amacı; merkez sözcükten çevredeki sözcüklerin tahmin olasılıklarını artıracak biçimde ifade edilebilir.
ya da;
Burada c, bağlam penceresinin yarıçapını; w_t, merkez sözcüğü göstermektedir.
Eğitim sırasında kullanılan Negative Sampling veya Hierarchical Softmax gibi teknikler, büyük sözlükler üzerindeki hesaplamayı daha yönetilebilir hâle getirebilir. Negative Sampling, tüm sözlük için tam olasılık dağılımı hesaplamak yerine seçili olumlu ve olumsuz sözcük çiftleri üzerinde ayırt edici bir hedef kullanır.
Temsili Python örneği / Skip-Gram eğitim çiftlerinin oluşturulması;
words = ["yeni", "ekran", "kartı", "yüksek", "performans", "sağlıyor"]
window = 2
pairs = []

for i, center in enumerate(words):
    left = max(0, i - window)
    right = min(len(words), i + window + 1)
    for j in range(left, right):
        if i != j:
            pairs.append((center, words[j]))

print([pair for pair in pairs if pair[0] == "kartı"])

Beklenen çıktı:
[('kartı', 'yeni'), ('kartı', 'ekran'), ('kartı', 'yüksek'), ('kartı', 'performans')]
Bu kod bir Word2Vec modeli eğitmez; Skip-Gram eğitiminde kullanılan merkez–bağlam çiftlerinin hangi mantıkla üretildiğini göstermektedir. Gerçek bir eğitimde bu çiftler, sözcük vektörlerini optimize etmek için kullanılır.
GloVe: Küresel Eş-Oluşum Bilgisini Kullanmak
Word2Vec’in tahmin görevi üzerinden ilerleyen yaklaşımına karşılık GloVe (Global Vectors for Word Representation), sözcüklerin derlem genelindeki eş-oluşum (co-occurrence) istatistiklerini doğrudan kullanmaktadır.
Jeffrey Pennington, Richard Socher ve Christopher Manning tarafından 2014 yılında yayımlanan model; sözcük–bağlam eş-oluşum matrisindeki bilgiyi yoğun vektörlere aktarmayı amaçlamaktadır.
Bir X matrisi düşünelim.
X_ij, i sözcüğünün j bağlam sözcüğüyle belirlenen pencere ve sayım kuralı altında kaç kez birlikte gözlendiğini temsil etsin.
GloVe bu gözlemler ile sözcük vektörleri arasındaki ilişkiyi, ağırlıklandırılmış bir hata fonksiyonuyla öğrenmektedir:
Formülde w_i ve ŵ_j sözcük ile bağlam vektörlerini; b_i ve b̃_j yanlılık terimlerini; f(X_ij) ise sık ve seyrek eş-oluşumların eğitime katkısını dengeleyen ağırlık fonksiyonunu ifade etmektedir. Toplam, uygulamada gözlenen (pozitif sayımlı) eş-oluşumlar üzerinde hesaplanır.

Örneğin; “anakart–işlemci”, “monitör–panel” veya “SSD–depolama” eşleşmelerinin derlemdeki dağılımları, uygun veride alan odaklı ilişkilerin öğrenilmesine katkı sağlayabilir.
Fakat GloVe da Word2Vec gibi klasik biçimiyle statik sözcük temsilleri üretir.
Bir sözcüğün farklı cümlelerdeki anlamına göre temsili otomatik olarak değişmez.
Feed-Forward Sinirsel Dil Modelleri
Sinirsel dil modelleme fikri, Word2Vec’ten önce de geliştirilmişti. Yoshua Bengio ve çalışma arkadaşlarının 2003 tarihli A Neural Probabilistic Language Model çalışması, sözcük temsilleriyle sözcük dizilerinin olasılıklarını birlikte öğrenen erken ve etkili örneklerdendir.
Feed-Forward Neural Language Model; N-Gram gibi belirli uzunluktaki önceki sözcükleri girdi alır, ancak bu sözcükleri ayrık sayaçlar yerine embedding vektörlerinden oluşan öğrenilebilir bir gösterim üzerinden işler.
Örneğin; “ürünün ses kalitesi oldukça …” ifadesinde model, önceki sözcüklerin vektörlerini birleştirerek gizli bir katmana aktarabilir ve “iyi”, “yüksek” veya farklı bir sözcüğün gelme olasılığını hesaplayabilir.
Genel yapı ise şöyledir;
Önceki n sözcük → Embedding katmanı → Birleştirme → Tam bağlantılı katman → Softmax → Sonraki sözcük olasılıkları

Matematiksel olarak ise;
Bu yapı; daha önce görülmeyen ama benzer sözcüklerden oluşan dizilere daha iyi genelleme yapabilir. Buna karşılık bağlam uzunluğu hala sabittir. Pencerenin çok dışında kalan bir bilginin modele aktarılabilmesi için girişin büyütülmesi veya farklı bir mimariye geçilmesi gerekir.
RNN: Dilin Sıralı Yapısını Öğrenmek
Recurrent Neural Network (RNN – Tekrarlayan Sinir Ağı), her adımdaki hesaplamaya bir önceki adımın gizli durumunu da katarak sabit pencere sınırlamasına farklı bir çözüm sunar. Jeffrey Elman’ın 1990 tarihli çalışması, yinelenen bağlantılar üzerinden dinamik bellek düşüncesini ortaya koyan etkili kaynaklardandır.
Basit bir RNN’in durumu şu matematiksel çözümleme ile ifade edilebilir;
Burada x_t o andaki sözcük vektörü, h_(t−1) önceki adımın gizli durumu, h_t ise yeni durumdur. Böylece model, sözcükleri birbirinden tamamen bağımsız değerlendirmek yerine, sıralı bilginin oluşturduğu bir geçmiş özetiyle çalışır.
Örneğin; “Müşteri ürünü satın aldı, ancak kurulum sırasında …” cümlesinde sonraki sözcüğü tahmin etmek için yalnızca en yakın iki sözcüğün değil, önceki bölümde anlatılan olayın da önem taşıması mümkündür. RNN, bu tür ilişkileri gizli durumunda taşıyabilecek bir yapıya sahiptir.
Ancak burada kritik bir sınırlılık bulunmaktadır. Ağ çok uzun diziler üzerinde geriye yayılım (Backpropagation Through Time – BPTT) ile eğitilirken, gradyanlar küçülebilir veya aşırı büyüyebilir.
Özellikle Vanishing Gradient (Kaybolan Gradyan) problemi, eski adımlardaki bilginin öğrenilmesini güçleştirir. RNN teorik olarak geçmişe bağlı olsa da pratikte her uzak ilişkiyi güvenilir biçimde koruyamaz.

LSTM ve GRU: Uzun Süreli Bağımlılıkları Modellemek
Long Short-Term Memory (LSTM) mimarisi; Sepp Hochreiter ve Jürgen Schmidhuber tarafından 1997 yılında önerilmiştir. İlk tasarımda giriş ve çıkış kapıları bulunurken, günümüzde yaygın kullanılan unutma kapısı (Forget Gate), Felix Gers, Jürgen Schmidhuber ve Fred Cummins tarafından 1999 yılında geliştirilmiş ve 2000 yılında yayımlanan çalışmayla literatüre kazandırılmıştır. Bu gelişme, LSTM hücresinin artık ihtiyaç duyulmayan bilgiyi kontrollü biçimde silmesini ve sürekli veri akışlarında hücre durumunu daha etkin yönetmesini sağlamıştır.
LSTM’de yapısal olarak üç ana kapıdan söz edilir;
- Forget Gate (Unutma Kapısı): Önceki hücre durumundan ne kadar bilginin korunacağını belirler.
- Input Gate (Giriş Kapısı): Yeni aday bilginin hücreye hangi oranda yazılacağını kontrol eder.
- Output Gate (Çıkış Kapısı): Hücre bilgisinin ne kadarının gizli duruma aktarılacağını belirler.
Hücre durumunun temel güncellemesi şöyledir;
Burada f_t unutma, i_t giriş kapısı; g_t yeni aday bilgi; ⊙ ise eleman bazında çarpımdır. Bu yapı, uygun koşullarda gradyan akışını destekleyerek uzun bağımlılıkların öğrenilmesini kolaylaştırabilir. Ancak uzun bağlamın her durumda eksiksiz korunacağı anlamına gelmez.
Gated Recurrent Unit (GRU) ise Cho ve çalışma arkadaşlarının 2014 tarihli Encoder-Decoder araştırmalarında tanıtılan, LSTM’ye göre daha sade kapılı tekrarlayan birimdir.
Yaygın GRU biçiminde Update Gate (Güncelleme Kapısı) ile eski ve yeni bilginin dengesi, Reset Gate (Sıfırlama Kapısı) ile aday durum hesaplanırken geçmiş bilginin ne ölçüde kullanılacağı kontrol edilir.

LSTM ayrı bir hücre durumu taşırken GRU bu amaç için birleşik bir gizli durumdan yararlanır. GRU’nun her zaman LSTM’den daha başarılı veya daha hızlı olduğu söylenemez. Performans; görev, veri boyutu, dizi uzunluğu, model kapasitesi ve eğitim koşullarına bağlıdır.
Chung ve çalışma arkadaşlarının 2014 tarihli karşılaştırmasında GRU’nun LSTM ile karşılaştırılabilir sonuçlar elde edebildiği raporlanmıştır; bu bulgu evrensel bir üstünlük kuralı değildir.
Encoder-Decoder: Bir Diziden Başka Bir Diziye
Metin sınıflandırmada çoğu zaman tek bir etiket üretmek yeterlidir. Oysa makine çevirisi, başlık oluşturma veya farklı uzunluktaki dizileri dönüştürme problemlerinde, girişteki sözcük sayısı ile çıktının uzunluğu aynı olmak zorunda değildir.
Bu noktada Sequence-to-Sequence (Seq2Seq) düşüncesi önem kazanmaktadır.
Encoder-Decoder mimarisinde iki işlev ayrılmaktadır. Encoder (Kodlayıcı) girdi dizisini işleyerek bir temsil oluşturur. Decoder (Kod Çözücü) ise bu temsilden yararlanarak hedef diziyi adım adım üretir. Cho ve çalışma arkadaşlarının 2014 Encoder–Decoder modeli ile Sutskever, Vinyals ve Le’nin yine 2014 tarihli çalışması, bu yaklaşımın sinirsel makine çevirisindeki önemli örnekleridir.
Örnekleyecek olursak;
Kaynak: “Ürün bugün teslim edildi.”
Hedef: “The product was delivered today.”
Başlangıçtaki birçok Seq2Seq sisteminde, bütün kaynak cümle belirli boyutlu tek bir bağlam vektörüne sıkıştırılır ve decoder bu vektörden çıktı üretir. Kısa girdiler için bu yöntem etkili olabilir. Ancak cümle uzadıkça, modelin bütün ayrıntıları tek bir sabit boyutlu özet içinde taşıması zorlaşabilir. Bu durum, Fixed-Context Bottleneck (Sabit Bağlam Darboğazı) olarak yorumlanır.

Attention: Her Çıktı Adımında Kaynağa Yeniden Bakmak
Attention (Dikkat Mekanizması), decoder’ın yalnızca sabit bir cümle özetine bağlı kalmak yerine, kaynak dizinin farklı kısımlarından her çıktı adımında yeniden yararlanabilmesini sağlar. Bahdanau, Cho ve Bengio’nun 2014’te ön baskı olarak yayımladığı ve ICLR 2015’te sunulan çalışması, bu yaklaşımın sinirsel çeviri açısından önemli dönüm noktalarından biridir.
Encoder’ın her kaynak sözcük için h_1, h_2, …, h_n durumlarını ürettiğini düşünelim. Decoder hedef dizinin t adımında önceki durumu s_(t−1) ile bu kaynak durumlarını karşılaştırarak uygunluk skorları hesaplayabilir;
Bu skorlar Softmax işleminden geçirilerek ağırlıklara dönüştürülür;
Ardından o çıktı adımına özgü bağlam vektörü oluşturulur;
Burada α_(t,i) değerleri negatif değildir ve her hedef adımında toplamları 1’dir.
Dikkat ağırlıkları, decoder’ın hangi kaynak konumlardan ne oranda bilgi topladığını belirler; fakat tek başına model kararının kesin ve tam açıklaması olarak değerlendirilmemelidir.
Örneğin; “Ürün bugün teslim edildi.” cümlesi İngilizceye çevrilirken “product” üretilen adımda “Ürün”, “today” üretilen adımda “bugün” sözcüğüne daha fazla ağırlık verilmesi makul olabilir. Ancak bu yalnızca açıklayıcı bir senaryodur; gerçek dikkat ağırlıkları eğitimli modelin çıktısından ölçülmelidir.

Attention ağırlıklarını hesaplamaya yönelik temsili python örneği;
from math import exp

scores = [1.0, 2.0, 0.0]  # Örnek uygunluk skorları
shifted = [exp(s - max(scores)) for s in scores]
total = sum(shifted)
weights = [value / total for value in shifted]

print([round(weight, 3) for weight in weights])

Beklenen çıktı: [0.245, 0.665, 0.09]
Bu örnekte ikinci kaynak konumunun ağırlığı daha yüksektir. Kod, yalnızca Softmax normalizasyonunu gösterir; Bahdanau Attention modelini eğitmez, skorları bir sinir ağı üzerinden üretmez.
Attention’ın tarihsel önemi, sabit bağlam darboğazını azaltmasının ötesindedir. Daha sonra Self-Attention ile aynı dizinin öğeleri arasında ilişkiler kurulmuş, 2017’de yayımlanan Transformer mimarisi ise tekrarlayan ağlara dayanmayan, Attention merkezli bir tasarım önermiştir. Bununla birlikte Encoder–Decoder Attention ile Transformer’ın bütün mimari bileşenlerini eşitlemek doğru değildir. Transformer’daki self-attention, pozisyon bilgisi ve çok başlı dikkat gibi ayrıntılar ayrıca ele alınmalıdır.
Mimarilerin Karşılaştırılması ve Türkçe NLP Açısından Değerlendirme
| Yaklaşım | Temel Öğrenme Amacı | Bağlam Yapısı | Belirgin Sınır |
| Word2Vec | Merkez sözcük ve yakın bağlamı tahmin etmek | Yerel pencere | Statik sözcük vektörü; bağlamdan bağımsız çok anlamlılık |
| GloVe | Küresel eş-oluşum ilişkilerini vektöre aktarmak | Derlem genelindeki eş-oluşumlar | Statik temsil; veri ve eş-oluşum kalitesine bağımlılık |
| Feed-Forward LM | Geçmiş sözcüklerden sonraki sözcüğü tahmin etmek | Sabit uzunluklu giriş | Uzak geçmişe doğrudan erişim yok |
| RNN | Önceki gizli durumla diziyi modellemek | Adım adım taşınan durum | Kaybolan/patlayan gradyan ve sıralı hesaplama |
| LSTM / GRU | Kapılarla ilgili bilgiyi koruyarak diziyi modellemek | Kapılı gizli durum / hücre durumu | Uzun dizilerde bellek ve eğitim maliyeti; sınırsız bağlam garantisi yok |
| Encoder–Decoder + Attention | Kaynak diziden hedef dizi üretirken ilgili konumları ağırlıklandırmak | Çıktı adımına özgü kaynak bağlamı | Mimari ve veri bağımlılığı; dikkat ağırlıklarının yorum sınırları |
Türkçe açısından bu dönüşümün ayrıca önemli bir yönü bulunmaktadır. “Ürün”, “ürünü”, “ürünün”, “ürünlerimizden” gibi biçimler aynı kökle ilişkili olsalar da sözcük düzeyinde farklı diziler olarak görülebilir.
Eklemeli dil yapısı, kelime dağarcığını büyütür ve az görülen biçimlerin temsilini zorlaştırabilir. Bu nedenle sözcük normalizasyonu, biçimbirimsel çözümleme ve alt-sözcük (subword) tabanlı yöntemler Türkçe NLP uygulamalarında kritik tasarım seçenekleridir.
E-ticaret yorumları veya ürün aramalarında “ekran kartı”, “ekrankartı”, “grafik kartı” gibi varyasyonlarla karşılaşmak mümkündür. Word Embeddings benzer kullanımları yakalamaya yardımcı olabilir; ancak yazım düzeltme, kelime sınırı belirleme, ürün adı tanıma ve kullanıcı niyetini anlama için yalnızca sözcük benzerliği yeterli değildir. Görevin niteliğine göre sıralı modelleme, bağlamsal temsil ve alan verisiyle değerlendirme birlikte ele alınmalıdır. Bu sistemleri karşılaştırırken yalnızca tek bir benzerlik örneğine veya dikkat haritasına bakmak da doğru değildir.

***
İstatistiksel doğal dil işleme yaklaşımları; dildeki belirsizliğin olasılıklarla ifade edilebilmesini sağlamıştı. Sinirsel mimariler ise aynı problem için daha esnek bir öğrenme alanı açtı. Word Embeddings ile sözcükler öğrenilebilir vektörlere taşındı; Word2Vec ve GloVe bu temsillerin geniş derlemlerden öğrenilmesini yaygınlaştırdı; Feed-Forward dil modelleri vektörleri olasılıksal sözcük tahminine bağladı. RNN dizinin geçmişini bir durum değişkeninde taşırken, LSTM ve GRU bu bilgiyi kapılarla yönetmeye çalıştı. Encoder-Decoder ve Attention ise bir dizinin başka bir diziye dönüştürülmesinde kaynak bilginin dinamik biçimde kullanılmasını mümkün kıldı.
Bu gelişmeleri birbirinden bağımsız algoritmalar listesi olarak değil, giderek büyüyen üç ihtiyaca verilmiş mimari yanıtlar olarak değerlendirmek daha doğru olacaktır;
Temsil öğrenmek, bağlamı korumak ve gerektiğinde ilgili bilgiye yeniden erişmek.
Bir sonraki bölümde; Self-Attention, Multi-Head Attention, Positional Encoding ve Transformer mimarisinin temel bileşenleri üzerinden bu dönüşümün günümüz büyük dil modellerine nasıl uzandığını incelemeye devam edeceğiz.
İyi çalışmalar.
***
Kaynaklar;
| Blogdaki Bölüm | Akademik Kaynak |
|---|---|
| Dağıtımsal Yaklaşım – Zellig Harris (1954) | Distributional Structure |
| Feed-Forward – Yoshua Bengio (2003) | A Neural Probabilistic Language Model |
| Word2Vec – Tomas Mikolov (2013) | Efficient Estimation of Word Representations |
| Skip-Gram ve Negative Sampling (2013) | Distributed Representations of Words and Phrases |
| GloVe – Pennington, Socher, Manning (2014) | GloVe: Global Vectors for Word Representation |
| RNN – Jeffrey Elman (1990) | Finding Structure in Time |
| LSTM – Hochreiter ve Schmidhuber (1997) | Long Short-Term Memory |
| Unutma Kapısı – Gers ve arkadaşları (2000) | Learning to Forget |
| GRU ve Encoder-Decoder – Cho (2014) | Learning Phrase Representations using RNN Encoder–Decoder |
| GRU–LSTM Karşılaştırması – Chung (2014) | Empirical Evaluation of Gated Recurrent Neural Networks |
| Seq2Seq – Sutskever, Vinyals, Le (2014) | Sequence to Sequence Learning with Neural Networks |
| Attention – Bahdanau, Cho, Bengio (2014/2015) | Neural Machine Translation by Jointly Learning to Align and Translate |
| Transformer – Vaswani ve arkadaşları (2017) | Attention Is All You Need |
| Attention’ın Yorumlanması – Jain ve Wallace (2019) | Attention is not Explanation |